
📜 Biography
I am a Ph.D. candidate at Beijing Institute of Technology (BIT), advised by Prof. Yuwei Wu and Prof. Yunde Jia. I received my master’s degree from Beijing Institute of Technology in 2023 under the supervision of Prof. Yuwei Wu and Prof. Yunde Jia, and my bachelor’s degree from Sichuan Normal University in 2018.
My research interests include:
- Embodied Intelligence: Memory and tool use for embodied question answering, reasoning, and decision-making.
- World Model: Modeling dynamic environments to predict future observations and support long-horizon interaction.
📖 Education
- 2023.09 - NOW,
 Ph.D. in Computer Science, Beijing Institute of Technology, Beijing, China.
- 2021.09 - 2023.07, M.S. in Software Engineering, Beijing Institute of Technology, Beijing, China.
- 2014.09 - 2018.07,
 B.S. in Computer Science, Sichuan Normal University, Chengdu, Sichuan, China.
📝 Publications
13 publications · 119 citations · Updated 2026-11-16 · Google Scholar
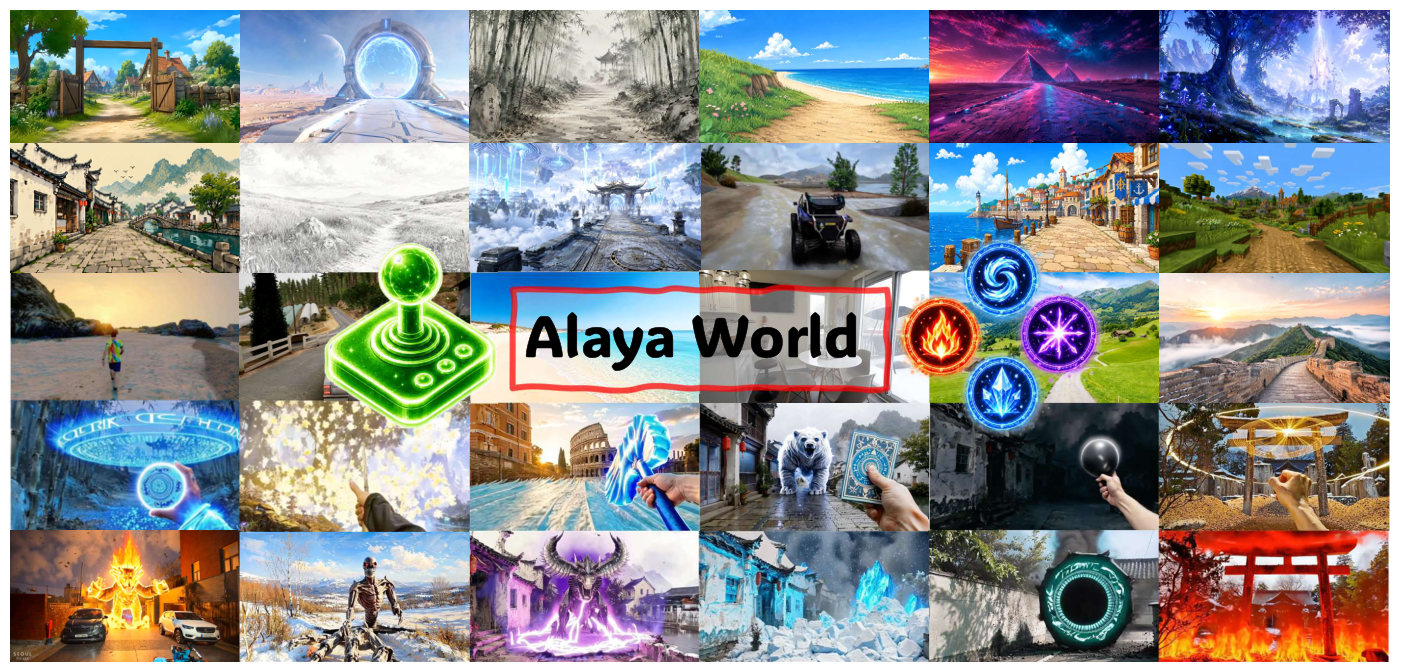
AlayaWorld: Interactive Long-Horizon World Modeling--Full Technical Report
- AlayaWorld Team, Kaipeng Zhang, Chuanhao Li, Yifan Zhan, Yongtao Ge, Yuanyang Yin, Jiaming Tan, Kang He, Liaoyuan Fan, Mingliang Zhai, Ruicong Liu, Xiaojie Xu, Xuangeng Chu, Zhen Li, Zhengyuan Lin, Zhixiang Wang, Zian Meng, Zihui Gao.
- arXiv preprint arXiv:2607.18367 [paper] [project] [code] · Citations: 17
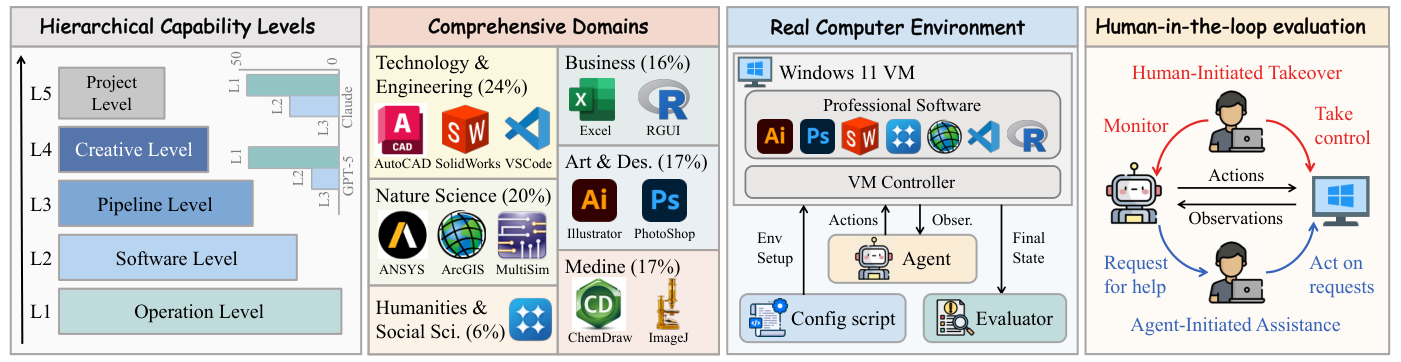
ProSoftArena: Benchmarking hierarchical capabilities of multi-modal agents in professional software environments
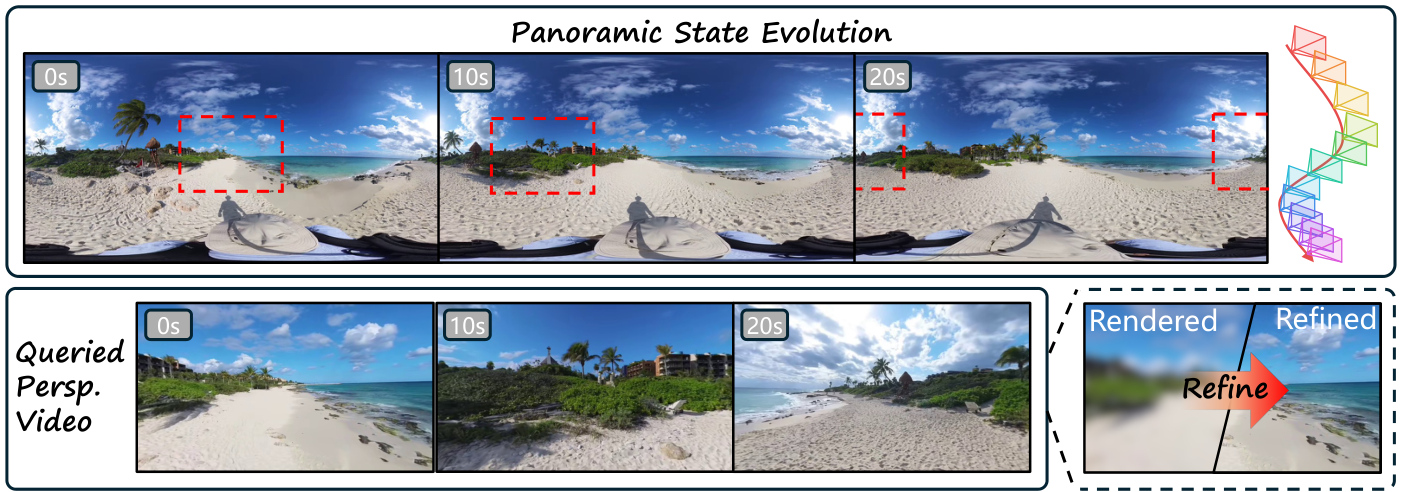


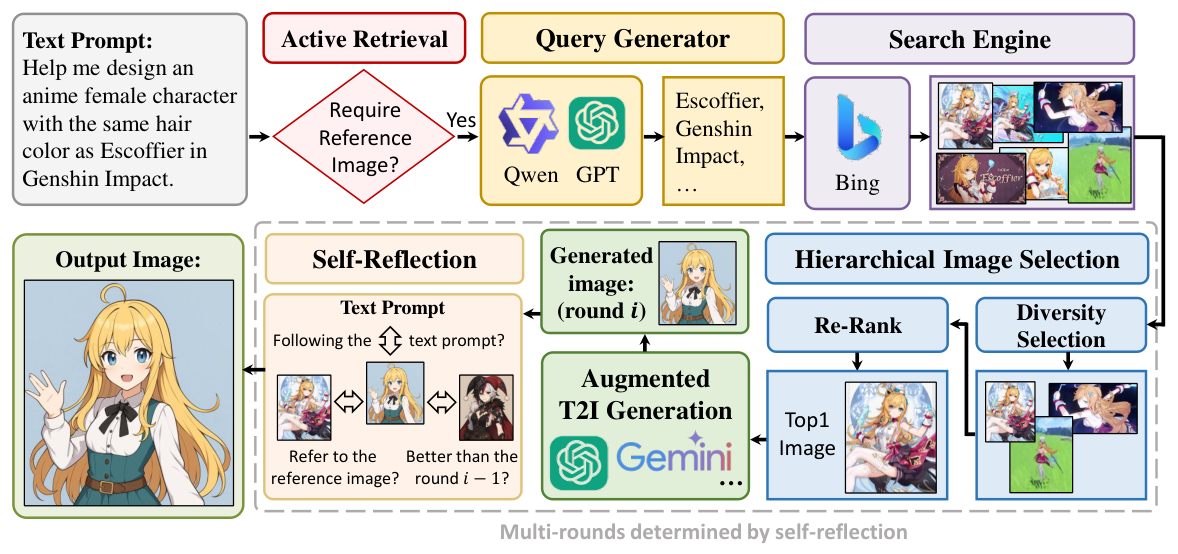
Ia-t2i: Internet-augmented text-to-image generation
- Chuanhao Li, Jianwen Sun, Yukang Feng, Mingliang Zhai, Yifan Chang, Kaipeng Zhang.
- arXiv preprint arXiv:2505.15779 [paper] · Citations: 6

In-Context Compositional Generalization for Large Vision-Language Models
- Chuanhao Li, Chenchen Jing, Zhen Li, Mingliang Zhai, Yuwei Wu, Yunde Jia.
- EMNLP 2024 [paper] · Citations: 12

Visual-Guided Reasoning Path Generation for Visual Question Answering
- Xinyu Liu, Chenchen Jing, Mingliang Zhai, Yuwei Wu, Yunde Jia.
- Chinese Conference on Pattern Recognition and Computer Vision (PRCV), 167-180, 2024 [paper] · Citations: 0

Fast-StrucTexT: An efficient hourglass transformer with modality-guided dynamic token merge for document understanding
- Mingliang Zhai, Yulin Li, Xiameng Qin, Chen Yi, Qunyi Xie, Chengquan Zhang, Kun Yao, Yuwei Wu, Yunde Jia.
- IJCAI 2023 [paper] · Citations: 14
Synthesizing Counterfactual Samples for Overcoming Moment Biases in Temporal Video Grounding
- Mingliang Zhai, Chuanhao Li, Chenchen Jing, Yuwei Wu.
- Chinese Conference on Pattern Recognition and Computer Vision (PRCV), 436-448, 2022 [paper] · Citations: 1
Search-T2I: Internet-Augmented Text-to-Image Generation
- Chuanhao Li, Jianwen Sun, Yukang Feng, Mingliang Zhai, Yifan Chang, Zhen Li, Kaipeng Zhang.
- [paper] · Citations: 0
🎖 Honors and Awards
- 2024.05, the innovation award in the “drive with language” track of [CVPR2024 autonomous grand challenge].
- 2023.01, the second prize in the multi-modal technology innovation competition of the first “Xingzhi Cup” National Artificial Intelligence Innovation Application Competition.
💼 Internship
- 2024.03 - 2024.08, Chongqing Changan Automobile Co., Ltd. Chongqing, China.
- 2022.06 - 2024.03, Baidu Inc. Beijing, China.